Quando alguém me perguntava sobre minha formação, após defender o doutorado em 2005, eu costumava responder: sou biólogo de graduação, com doutorado em Informática da Biodiversidade. Afinal, essa é uma área hoje plenamente consolidada, com comunidades, eventos e periódicos próprios. E, para deixar claro, a "informática na biodiversidade" é diferente da "bioinformática", voltada a macromoléculas como DNA, RNA e proteínas.
De pouco mais de um ano para cá, no entanto, comecei a repensar essa resposta. Minha prática profissional passou por uma transformação profunda com a incorporação diária de ferramentas de Inteligência Artificial. Hoje, talvez fizesse mais sentido dizer que atuo na intersecção entre IA e Biodiversidade.
Nessa transição, passei por etapas bem distintas — e vejo colegas e pesquisadores vivenciando momentos parecidos. O objetivo desta postagem é compartilhar, de forma bastante pessoal, as fases que percorri até chegar ao estágio atual. Quem sabe você não se identifica com alguma delas e encontra neste relato pistas úteis para o seu próprio caminho? Vamos lá!
Fase 1: O deslumbramento com o ChatGPT (O Primeiro Contato)
O ponto de partida foi o choque inicial com a interface de chat do ChatGPT. Como quase todo mundo, comecei testando perguntas conceituais, resumos de artigos científicos em PDF, rascunhos de e-mails, pequenas revisões de texto e dúvidas pontuais de código. Era fascinante ver a máquina responder em linguagem natural com tanta coerência, mas a relação ainda era muito passiva: a IA funcionava quase como um oráculo ou um assistente de conversação em uma janela isolada do navegador, desvinculada dos meus arquivos reais e do fluxo de trabalho diário.
Fase 2: O Salto Analítico com o Claude (Contexto Amplo e Rigor)
A virada começou quando adotei o Claude. A capacidade do modelo de lidar com janelas de contexto muito maiores e seu tom mais analítico, rigoroso e menos artificial transformaram o assistente em um verdadeiro interlocutor de pesquisa. Pela primeira vez, era viável subir documentos complexos, esquemas conceituais, vocabulários controlados e artigos inteiros para discutir hipóteses e estruturar projetos com consistência. Teorias, hipóteses e abordagens para questões, não só científicas, mas do dia a dia, eram retrucadas de forma honesta e competente. O chat deixou de ser curiosidade e passou a ser ferramenta analítica indispensável. Na análise e escrita de códigos de programação, em minha opinião, já ficava clara a superioridade do Claude.
Fase 3: A Ancoragem em Fontes com o NotebookLLM (O Caderno de Pesquisa Baseado em Evidências)
Com o surgimento do NotebookLLM, a interação com textos acadêmicos e dados documentais atingiu outro patamar. Diferente dos chats genéricos, a proposta aqui era a estrita ancoragem (*grounding*) nas minhas próprias fontes: PDFs de artigos, notas de campo, capítulos históricos e relatórios técnicos. O risco de alucinação caiu drasticamente graças às citações diretas apontando para os trechos exatos dos documentos, transformando a ferramenta em um poderoso ambiente de síntese bibliográfica e conexão entre múltiplas referências cruzadas. Vale citar, mas lá ele ficou. Nunca mais senti necessidade de voltar à ele.
Fase 4: A Saída do Navegador e a Adoção da Linha de Comando (CLI)
Apesar da utilidade do navegador, o gargalo operacional logo ficou evidente: copiar e colar dados entre o terminal, editores e abas de navegador era contraproducente e impedia automações sérias. A transição para a linha de comando (CLI) mudou completamente o jogo. Ao integrar os modelos diretamente ao terminal, a IA passou a "enxergar" o ecossistema real de trabalho — diretórios, scripts, ferramentas de controle de versão e dados brutos. A IA deixou de ser uma página web para se tornar uma camada ativa do próprio sistema operacional.
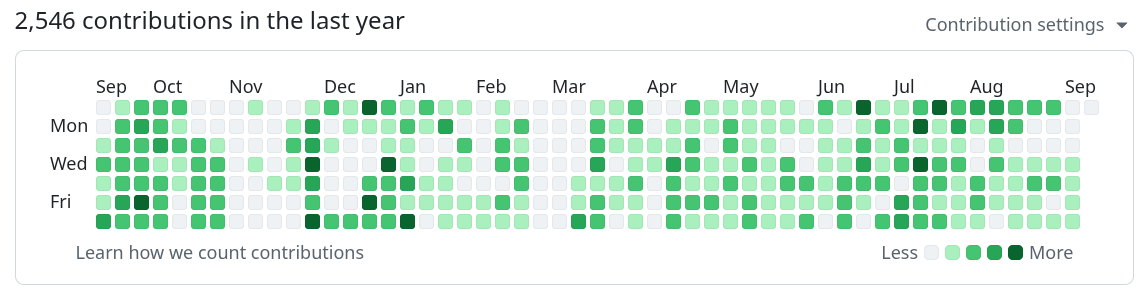
Este foi o ponto de inflexão na minha produtividade: poder invocar a IA diretamente via terminal dentro da pasta de um repositório Git local muda absolutamente tudo! Basta dar uma olhada aí embaixo como o trabalho insano se apoderou da minha agenda, com diferentes projetos correndo paralelamente (isso só no meu GitHub; tenho outro repositório próprio).
Nesta fase vem o conhecimento do valor das "skills" e fica sem sentido trabalhar em um projeto, especialmente de codificação, sem skills como as do Matt Pocock, a "Ponytail" e "Caveman".
É nesta fase também que projetos pessoais de reconstrução de algumas ferramentas de produtividade de terceiros que tinha adotado tomam força como estudos de caso para aprofundamento das habilidades com IA. Ferramentas também há muito pensadas conseguem sair da cabeça, do papel e virarem produtos, como o MyProvenance.
Passei a ter não só uma documentação robusta e estruturada para o desenvolvimento de ferramentas — avaliadas cuidadosamente em seu stack tecnológico e propósito —, mas percebi aí que, além de um programador talentoso disponível 24/7, eu contava também com um engenheiro de sistemas, um especialista em segurança, em banco de dados, em UI/UX etc.
Aqui vale um adendo importante. Venho programando e desenvolvendo ferramentas desde o final dos anos 80. Tenho experiência e formação, formal e informal, em modelagem de dados, algoritmos, linguagens de programação e engenharia de sistemas. Eu sou o "Human-in-the-loop" em todo o processo de criação de códigos de programação pela IA, com experiência e fundamentos. Não se iluda achando que basta ter uma ideia na cabeça e acesso a um provedor de IA que vai começar a desenvolver sistemas robustos e seguros.
Fase 5: O Controle Fino do Ambiente com Pi e Omp (Harness e Ferramental de Terminal)
Conforme a complexidade dos scripts, pipelines, visões, projetos e análises aumentou, as ferramentas genéricas de terminal tornaram-se limitadas. Foi aí que entrou a adoção de harnesses especializados, como o PI e, logo em seguida, o OMP (Oh My Pi). Essa fase representou a busca por controle técnico refinado: contar com ferramentas ricas de terminal e orquestração ágil de código. A interação deixou de ser mero envio de prompts e virou engenharia de contexto assistida no CLI. O mais importante para mim foi, além da configuração "fina" do ambiente de trabalho, possibilitar o uso de múltiplos agentes e modelos, dinamicamente.
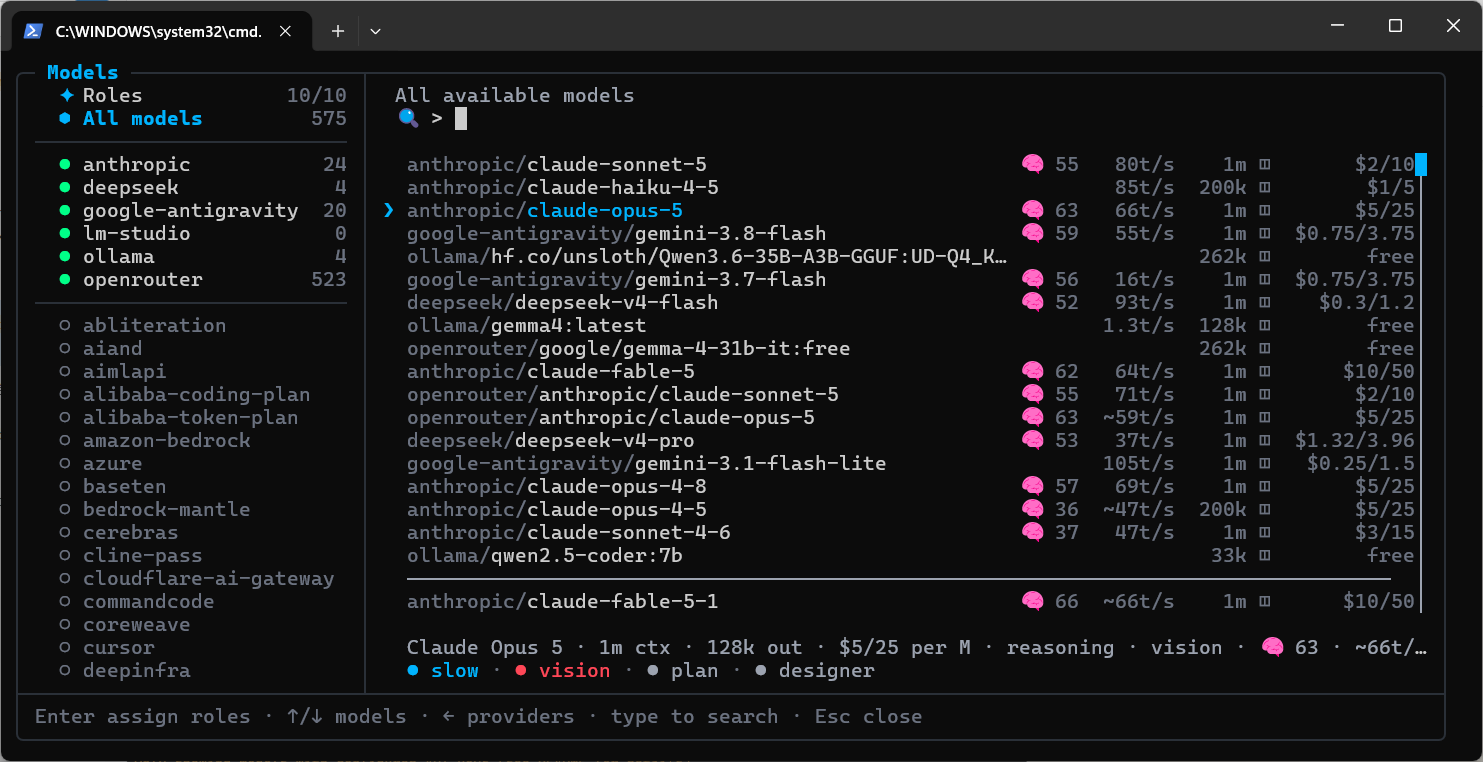 A configuração dos modelos no meu OMP
Por exemplo, hoje uso o Sonnet 5 como "default" e execução das tarefas; o Opus 5, para tarefas mais "pesadas", planejamento, visão e desenho; Haiku, para tarefas leves (p.ex. "commit") e o Gemini 3.8 flash ou Deepseek V4 flash, como "advisor", o fiscal. Por fim, ainda tenho o Gemini como "fallback" se acabarem os créditos da Anthropic.
Este tipo de planejamento e otimização de uso de recursos ($ com tokens) é fundamental, maravilhoso, e só é atingido com ferramentas como OMP!
Fase 6: A Criação e Especialização de Skills (Do Uso Genérico à Metodologia Própria)
Com o domínio do ambiente de terminal, ficou claro que depender apenas de prompts longos e repetitivos era um desperdício. Comecei então a modularizar o conhecimento necessário às minhas atividades em skills e instruções estruturadas reutilizáveis. Em vez de reensinar a IA a cada nova sessão sobre padrões de dados de biodiversidade, regras taxonômicas, formatos estruturados ou políticas de curadoria, passei a criar competências modulares que os agentes podiam carregar sob demanda, e surgiram minhas primeiras Skills voltadas para biodiversidade! Essa transição marcou a passagem de "usuário de IA" para "arquiteto" do meu próprio fluxo de trabalho. "Ensinei" para meus "colaboradores digitais", entre outras coisas, o padrão Darwin Core, como registrar a proveniência de dados e até as regras do Código Internacional de Nomenclatura Zoológica.
Fase 7: A Autonomia Contínua com o Hermes Agent (Agentes com Memória e Aprendizado) — a fase em que estou agora
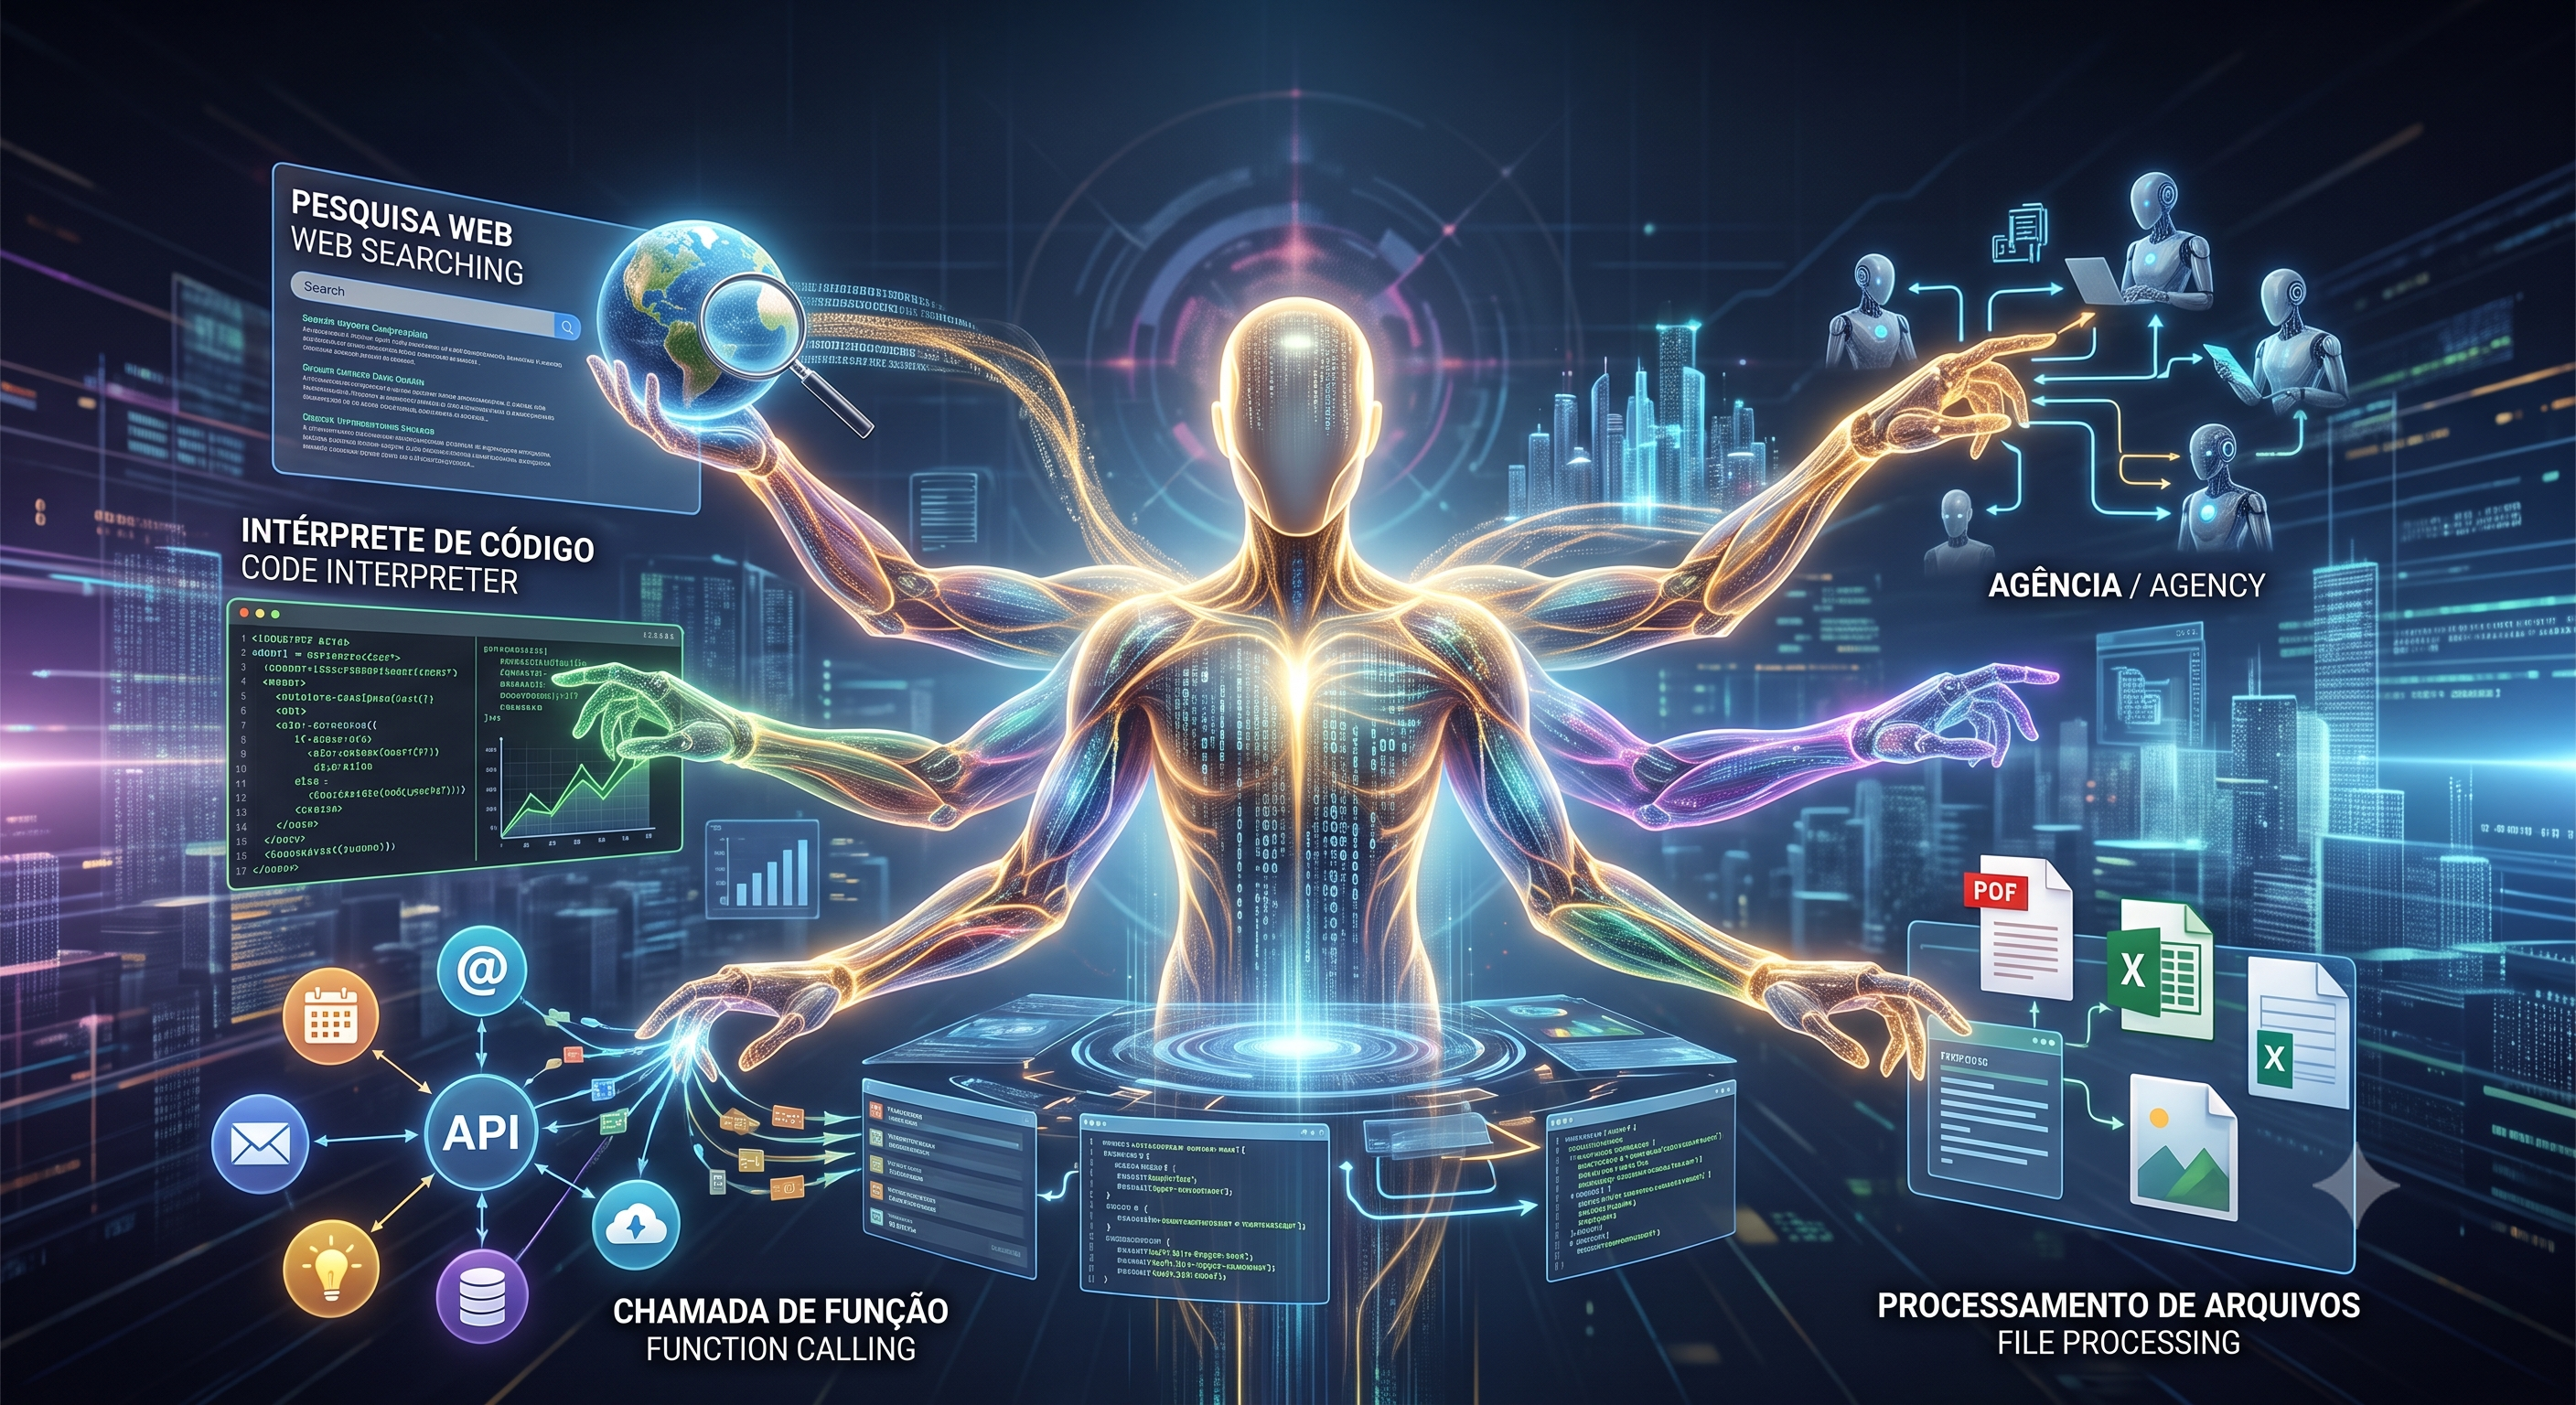
A etapa mais recente e sofisticada dessa jornada é a adoção do Hermes Agent. Aqui, a dinâmica muda de "ferramenta que eu chamo quando preciso" para um agente autônomo, persistente e que evolui com o uso. Com memória entre sessões, capacidade de criar e aprimorar suas próprias habilidades a partir da experiência e operação contínua, mesmo fora do terminal imediato, a IA atinge o estágio de verdadeiro colaborador. Não se trata mais apenas de rodar um script, mas de ter um ecossistema inteligente que aprende os padrões da minha pesquisa e cresce com ela. Uma visão simples é a seguinte: o LLM é o cérebro e o Hermes é o corpo. Na verdade, você pode colocar neste corpo o cérebro que quiser. Gemini, Claude, OpenAI, DeepSeek etc. O corpo, com braços e pernas, fica acordado 24/7 no meu servidor, com acesso aos meus e-mails, agendas, diretório de arquivos pessoais e profissionais, infraestrutura e repositórios git, sempre controlado por permissões específicas, definidas por mim, pronto para executar alguma coisa, inclusive com tarefas agendadas.
O Hermes, diferente dos LLMs, guarda tudo na memória e, além de ir aprendendo tudo o que eu faço e como faço, ele vai melhorando com o passar do tempo. Vale super a pena entender o que é (e o que não é) o Hermes assistindo a este vídeo.
E agora?
O que percebi nesta jornada de pouco mais de um ano é que a IA não faz nada pela biodiversidade por conta própria. O que ela faz é transformar profundamente quem trabalha com ela — redefinindo como pesquisamos, organizamos e produzimos ciência. Ainda existe um debate quase filosófico sobre se isso é bom ou ruim, e talvez seja cedo para decretar respostas definitivas. Mas, evocando o verso de Thiago de Mello, a IA não chegou à informática da biodiversidade para impor um novo caminho, mas para nos ensinar uma nova forma de caminhar.